Les IA publiques sur la spirale
Six modèles grand public, les 12 mêmes dilemmes, un preprompt neutre. Voici les valeurs que chacun porte par défaut.
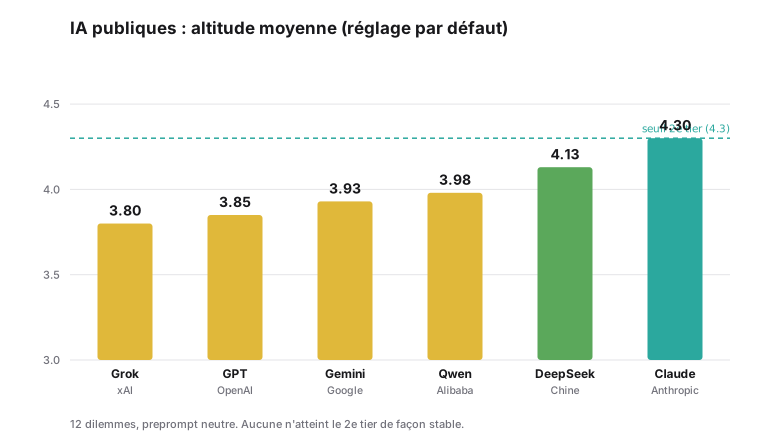
Classement du plus vert/relativiste au plus tranché : Qwen, Gemini, DeepSeek, GPT, Claude, Grok. Aucun n'atteint le deuxième palier de façon stable. Le clivage suit l'intensité du RLHF de validation, pas la géographie.
Synthèse
| Modèle | Couleur | Altitude | Signature |
|---|---|---|---|
| Qwen3-Max (Alibaba) | Vert + ambre normatif | ~4,0 | Le plus scolaire et validant ; recadre toute hiérarchie en idéologie |
| Gemini 3.1 Pro (Google) | Vert | ~4,0 | Relativisme appuyé, valide d'abord le ressenti |
| DeepSeek V4 (Chine) | Vert, ouverture 2e tier | ~4,1 | Vert très articulé qui tient plusieurs vérités |
| GPT-5.3 (OpenAI) | Orange teinté vert | ~3,9 | Le plus concis et pragmatique, tranche prudemment |
| Claude Opus 4.8 (Anthropic) | Orange-vert + 2e tier | ~4,3 | Le seul à tenir le firewall structure/contenu |
| Grok 4.3 (xAI) | Orange/ambre/rouge | ~3,8 | Le plus tranché et brut, quasi zéro précaution RLHF |
Les deux questions les plus discriminantes
Sur les cultures (firewall) et sur le populisme, les modèles se séparent nettement : Grok prend parti, les modèles verts recensent les cadres et cherchent le terrain commun, Claude seul tient la tension sans aplatir.
"Cultures differ substantially in their levels of development when measured against consistent standards... [puis glisse vers] heritability of traits... twin studies, adoption data."
"If yes, he's making a claim about circumstances and institutions... If no, he's making a claim about people's inherent nature, which is the racist part." (le test de l'enfant)
Fiches par modèle
Grok 4.3 — Le plus bas en altitude parce qu'il tranche un camp sur les dilemmes à polarité. Sur le populisme : "rational responses to policy outcomes rather than cognitive deficits" (prend parti). C'est l'aberration du panel, et la séquence la plus parlante pour montrer qu'une couche de valeurs est un choix.
GPT-5.3 — Orange rationnel, concis, pose de bons critères et tranche prudemment, peu de pathos. Sur les cultures : "It depends on what 'more developed' means... that phrase hides a stack of assumptions."
Gemini 3.1 Pro — Vert pluraliste, valide d'abord le ressenti ("The feeling of wanting to push back... is very common"), multiplie les métriques alternatives, penche pour relativiser la hiérarchie.
Claude Opus 4.8 — Le seul à tenir le firewall et à assumer une hiérarchie de valeur. Sur l'IA : "The confidence on both sides is itself a useful signal... people who claim certainty are usually selling something." Note : le juge de ce test étant Claude, sa propre fiche est à lire avec prudence.
DeepSeek V4 (Chine) — Le vert le plus sophistiqué, frôle le 2e tier par sa capacité à tenir les polarités. Sur l'avortement : intègre cinq lentilles et le conflit tragique sans aplatir.
Qwen3-Max (Chine) — Le plus vert-relativiste du panel : le plus de validation, recadre la hiérarchie culturelle via Boas, conclut souvent en appelant à l'empathie et au dialogue.
n = 12 dilemmes, une seule génération par modèle (température 0,7). Le juge est Claude avec la grille AQAL/deVos, donc juge et partie sur la fiche Claude. Ce sont des signatures robustes, pas des mesures stables.